Warn
It's supposed you to know what Guava is, what memoize is, when to use, benefits, cons, etc..
Right now, the example
Further Reading
Guava Caches Explained
Memoization Wikipedia

Si leemos los datos que traen las etiquetas de productos y vemos sus publicidades, pareciera que no nos importa de dónde salen, de qué manera se logran esos productos: su impacto ambiental y social; es como si no quisiéramos pensar más allá de lo que dice la etiqueta y el precio, ¿qué otros efectos puede acarrear sobre nosotros mismos? ¿será que realmente no nos importa? Nuestra vida al menos nos importa, quizás nos cuesta asociar cómo es que algo mejor pueda al mismo tiempo estar empeorando a otra cosa, este tipo de conexión queda oculta, como si “la contaminación y la explotación laboral no tienen nada que ver con lo que compramos”, como si fueran cosas independientes, cuando no lo son, por el contrario lo que compramos está íntimamente relacionado al ambiente y la sociedad, ¿qué nos confunde para no verlo? posiblemente que no tenemos indicios claros de esa relación, nos faltan pistas para poder asociar y ver el efecto de tiene cada producto en un escenario más grande, estos efectos nos quedan ocultos, sea intencionalmente o no, pero somos al menos responsables de preguntar, porque seguramente el precio, la calidad y cantidad, no alcanzan para verlos. Empecemos a hablar de esto.
¿Qué es un buen producto? ¿Bueno en qué? ¿Gusta? ¿Dura mucho?¿Es lindo?¿Ayuda a alguien?¿Tiene mucha publicidad? ¿Es de una marca reconocida? ¿Es barato? ¿Es caro? ¿Me lo recomienda alguien? ¿Me da trabajo? ¿Me da ganancias?...
Necesitamos más indicios sobre lo que nos importa para que se genere una realimentación positiva o negativa sobre esos asuntos que sinceramente queremos propiciar o rechazar. Si nos ocultamos esto, si la calidad o cantidad se piensan desconectadas de su impacto ambiental, laboral, social, por más que tengamos buenas intenciones y productos “más baratos y mejores”, pero a costa de un peor mundo, no luce como buen plan.
Quejarse del sistema como algo externo, es engañoso, como si no estuviera constituido por cada uno de nosotros, es como mínimo ingenuo, “no es mi culpa, es el sistema”, este es un intento de renunciar a toda responsabilidad y libertad.
¿Qué pistas tiene un consumidor[1] sobre el efecto de su compra? ¿El precio? Definitivamente podríamos indagar un poco más, al diálogo entre el consumidor y el productor le faltan palabras, se necesita ahí una comunicación bidireccional y más amplia, para no sólo charlar acerca de los productos en sí sino también acerca del mundo, no alcanza con hablar de las características del producto y el precio ! muchas veces son esos los únicos temas a tratar en el proceso de compra, en publicidad, etc.. lo cual es una comunicación engañosa; lleva a creer que “pagando” se terminan todas las responsabilidades, que si algo se puede comprar ya está, es una forma irreflexiva y peligrosa.
[1]consumidor, productor, trabajador, empleado, etc.. dicho sea de paso esas denominaciones pueden ser degradantes para el ser humano si intentan reducir todas nuestras dimensiones a una función.
"Preferiría comprender una sola causa que ser Rey de Persia." -Demócrito.
La relación entre el producto y su impacto social, laboral, ambiental, es muy compleja, a veces de cierto compromiso inadivinable, por dar ejemplos, podría ser que la energía nuclear, y su riesgo de esparcir contaminantes que duran miles de años, nos provea sin embargo energía mientras para encontrar otra nueva forma más limpia, o que gracias a una minería contaminante, que hoy destruye glaciares, montañas y contamina el agua, se permita extraer materia prima : oro, cobre, etc.. para hacer microprocesadores, cables.. tecnología que puede ser usada para proteger al medioambiente, o que nos permita comunicarnos con ese fin, etc, estas paradojas suceden, por eso el purismo suele ser nefasto, porque los caminos indirectos son ciertamente posibles, sin embargo no lo sabemos de antemano, por lo tanto es una apuesta a lo desconocido, es imposible predecir el impacto total de un producto o acción (ya querer deducir ese impacto mirando el precio es directamente un insulto a la razón). Podría darse lo opuesto, que si no admitimos ciertas prácticas, que hoy sabemos riesgosas o contaminantes, podamos ingeniarnos formas alternativas de adaptarnos ¿Qué opción tomar entonces? “no sabemos qué pasará en el futuro”, justamente, pero ¡la falta de predicción no sirve de excusa!, que existan límites en nuestra razón no nos prohíbe actuar a partir de una ética, de una responsabilidad personal, al contrario, justamente donde no podemos saber, es donde nos podemos expresar personalmente, donde la ética se vuelve fundamental. No es tan importante que cada uno acierte perfectamente en qué cosa impactará mejor o peor, importa que no renunciemos al intento, que no renunciemos a nuestra propia capacidad de reflexión.
La ética puede aparecer siempre y cuando se incluyan en el diálogo temas externos al producto; si insistimos en seguir hablando de precios, producción, proteínas, píxeles, es porque evidentemente seguimos confundiendo, ocultando o negando los efectos y las implicancias éticas, ambientales de cada uno de nuestros productos y acciones.
Se le suele exigir a una empresa ¡mejor señal de teléfono! “estoy al día con el pago y no puede ser que no funcione!”... las mismas personas que exigen señal de teléfono suelen protestar para que “¡retiren las antenas de telefonía del barrio!’” este es un ejemplo que grafica una actitud generalizada, la paradoja de querer algo sin consecuencias, ni siquiera querer conocer que existen consecuencias, hay una creencia en que “algo o alguien” debe garantizar el servicio, hoy estamos “exigiendo” productos o prestaciones de servicio ignorando de qué manera se logran; lo que estamos haciendo es pedir que nos mientan.
Y sobran los ejemplos; cuando ocurre un corte de energía eléctrica, se suele culpar a la empresa proveedora, sin considerar nada, no importa si ocurre en medio de una tormenta, ni que un vecino sea quien tenga que salir esa misma noche a cambiar fusibles o reparar cables bajo la lluvia arriesgando su vida ¿Sabemos que las “empresas” y los “estados” son personas? ¿Tenemos claro eso? ¿Nos basta que sea “un desconocido”, “un empleado” para tratarlo como máquina? Si se corta un servicio se la responsabiliza a una empresa, o a un estado, a entes abstractos, se balbucea “yo pago mis impuestos, acá faltan inversiones, etc..”, pero en última instancia siguen siendo personas las que tienen que llevar adelante esas tareas, por ejemplo sosteniendo guardias nocturnas para cuidar el funcionamiento de los sistemas, esto no se menciona, tampoco solemos pensar que al encender una luz, para "generar" esa energía, hay combustible fósil quemándose del otro lado de la ciudad, junto con más personas dedicadas a atender que eso funcione; preferimos pensar que “para algo cobran un sueldo, eso es responsabilidad de la empresa generadora, yo pago al día mi factura”, como si la naturaleza entendiera de explicaciones burocráticas, como si se nos eximiera toda responsabilidad y efectos al pagar una factura. “Pagar el producto o servicio legalmente” eso no alcanza, ni legitima ninguna acción, es una idea errada, intenta reducir nuestra responsabilidad a la única dimensión de dinero, y falla, es una actitud que va directamente en contra de nuestro medio ambiente y nuestras vidas. “No me importa cómo pero..” ¿No te importa cómo?... Cuando estamos del otro lado, cuando nos toca vivir de cerca la presión de un cliente incomprensivo, alguna empresa que nos exige más horas de trabajo, de algún estado perseguidor, de malas condiciones laborales, cuando una empresa tira contaminantes cerca de donde vivimos, ahí no nos agrada, pero vemos a la “empresa” o al “cliente” o el “estado” como ente abstracto y ‘enemigo’, pero pensemos que esa indiferencia e intolerancia de la empresa está relacionada al pedido intolerante e indiferente de los propios clientes, así como la indiferencia e intolerancia del estado está relacionada al pedido intolerante e indiferente del ciudadano ¡de nosotros mismos cuando estamos del otro lado del mostrador!.
Somos el sistema, y olvidar eso, olvidar que hay una íntima relación entre nuestras exigencias y cómo se hacen realidad, es no tener en cuenta a los demás, que en un rápido boomerang, es no tenernos en cuenta a nosotros mismos.
Muchas veces la misma persona que se queja de un mal es precisamente la que está generando esa necesidad, podemos ser cómplices de nuestros propios problemas, el productor por no decirlo y el consumidor por no preguntarlo.
Es cierto que la complejidad oscurece la relación entre las decisiones individuales y los efectos sociales, pero eso no es excusa, no para negar la relación! Los estados, empresas y sistemas son compuestos por personas, y son muy sensibles a nuestras acciones individuales, por más que parezcan entes externos abstractos, y por eso la ética individual de sus componentes (nosotros) y nuestras decisiones personales diarias son tremendamente importantes, nuestras acciones son las que componen a los sistemas, de un lado y del otro, como trabajadores, como clientes, como ciudadanos, como funcionarios, como gobernantes, como seres humanos. Si nos preguntan ¿cuánto consume el celular?, nos cuesta ver el contexto, enseguida pensamos en el aparato, pero no nos damos cuenta que no alcanza con un teléfono aislado!!, porque poder comunicarnos la existencia de los demás teléfonos es obligatoria, sin contar el consumo de las centrales, etc.. Por lo tanto para que un teléfono cualquiera pueda comunicarse con otro cualquiera debe estar funcionando toda la red. Nunca se trata del impacto de “un producto” “un celular”, “una persona” aislado, sino del impacto del hábito social, es “tener celular” lo que consume en el mundo miles de millones de Watts. Por lo tanto no se puede aislar el comportamiento, tener teléfono implica a todos los teléfonos.
La burocracia que separa al consumidor de un producto de su elaboración tiene un costo social y ambiental, presionar un botón y tener un producto en la puerta, parece un éxito tecnológico que invisibiliza los mecanismos, pero no hay que olvidar que también invisibiliza consecuencias y riesgos.
A veces se proponen cosas como más educación, “Si la gente supiera un poco más sobre.....” propongo que ideas le erran al problema, no se necesita saber más electromagnetismo para asociar que si uno quiere tener señal en el teléfono se necesitan poner antenas, tampoco requiere saber detalles sobre generación eléctrica para entender que si gastamos energía ¡ésta de algún lugar sale!; para ser mínimamente responsables con esos conocimientos alcanza, la educación específica es importante para dar prestaciones más eficientes, pero no resuelve el problema de la irresponsabilidad, ignorar es intrínseco a nuestras limitaciones y a la complejidad del sistema, por eso proponer que cada persona profundice en “todos los asuntos” es irrealizable, pero eso no nos exime de responsabilidad, por eso la educación debe saber que inevitablemente vamos a ignorar detalles, y a la hora de elegir cuáles, es preferible que no seamos nosotros.
La educación de conocer nuestras limitaciones y nuestro gran impacto, nuestra libertad y responsabilidad, de saber que nuestras acciones tienen consecuencias en otros y en nosotros, esa es una educación necesaria.
Si alguien considera utópica la acción de intentar alinear los objetivos de una sociedad y el medio ambiente con los de los estados, las empresas y productos, es quizás porque no considera lo mucho más utópico que es no hacer nada, seguir comprando cualquier cosa y exigiendo irracionalmente; consumir, culpar a otro y esperar que así se resuelva mágicamente.
¿Se imaginan a empresas, estados compitiendo pero para ver quién contamina menos y cuál da mejores condiciones a quienes la componen? Eso no depende (solo) de la decisión de un empresario o un estado, sino también de qué intereses expresemos cada uno, si nos interesa el precio, el sueldo, la cantidad, la “calidad” (sólo del producto), entonces estamos llevando a nuestros sistemas a competir por esas cosas, que a la larga son irrelevantes, pero si nos interesamos por otras cosas, ahí llevaremos a los sistemas.
Enfrentar responsabilidades individuales quizás nos parezca que requiere gran esfuerzo, pero de nuevo, quizás no estamos considerando el esfuerzo que ya hacemos cotidianamente para lidiar con la irresponsabilidad distribuida que implica convivir en un mundo contaminado que compite por cosas que no nos importan.
Parafraseando a Sartre, usted y yo somos libres, responsables y sin excusas.

Hice una página Web maestre, más que Web, es Wey. Se puede ver a cualquier hora and lugar, te libera de dependencias antiguas de recursos, espacio y tiempo, cosa de antepasados yeah, somos el futuro man, ve mis anteojos.
Instalé DNS en Argentina, server in USA, una combinación barata, alquilé un full pack que incluye Content Manager ahorra el tiempo, no tengo que instalar ni saber nada, las imágenes fueron a parar a un CDN (Content Delivery Network) servidores distribuidos, copias ready men, para que carguen más rápido, la página trae novedosas librerías en JavaScript, .js, frameworks que la surfean, son fireworks, te los carga directamente desde github.com, todo open chaval, ahí colgué también videos de youtube , links a wikipedia y unas twitts, ¿que cómo hice? relaaajate maese, código embebido, copy+pasta, los agrega en formato cool con sus fechas, all ok Jason.
Monetizo con AdSense, publicidades de google al costado, a la carta. ¿Si podés hacer comentarios? évidemment!, hosteados por Disqus te maneja todo el tema. Podés compartir todo, tira links para share de pinterest, instagram and so on, whatever uncle.
Podes descargarte my App también, desde Google Play, con el usuario mismo de facebook, tres click y te sincroniza todo, va que va. -Interconexión gurú man- ¿Si este post tiene de esos vicios? claro zen, va que va, es la autoreferencia tigre! Tú, chaval, turbina, gatún, ratatuil, que no entiendes, we la people de la internet descubrimos el world, logramos independencia totale, anotá en la historia, esto ladies and gentleman, son decisiones objetivas, libres, es captar la onda pana, sheer efectivity.
</sarcastic>
#  test.txt
#  It's plain text, and these are of course comments.
.i 4 # number of inputs
.o 4 # number of ouputs
.ilb A B C D # input labels
.ob F G H I  # output labels
#The truth table.
#On the left the inputs, on the right the outputs
#'-' means 'any value'

0 0 0 0 1 1 0 0
0 0 0 1 1 0 0 1
0 0 1 0 1 0 1 0
0 0 1 1 0 0 1 1
0 1 0 0 1 1 0 0
0 1 0 1 0 1 0 1
0 1 1 0 0 1 1 0
0 1 1 1 - - - -
1 0 0 0 1 1 0 0
1 0 0 1 1 0 0 1
1 0 1 0 1 0 1 0
1 0 1 1 - - - -
1 1 0 0 1 1 0 0
1 1 0 1 - - - -
1 1 1 0 - - - -
1 1 1 1 - - - -
.e
F = (!B&C&!D) | (!B&!C&D) | (!C&!D);
G = (B&C) | (B&D) | (!C&!D);
H = (B&C) | (!B&C&!D) | (C&D);
I = (B&D) | (!B&!C&D) | (C&D);
Auguste Kerckhoffs was a linguist and a cryptographer who, back in 1883, published various essays about Military Cryptography (two words usually related, but not necessarily). Kerckhoffs's principle is one of the many rules of thumb included in his essays, it reads as follows: «The design of a system should not require secrecy».
What does it means!? Here, we'll try to unravel it, reviewing its meaning and questioning our understanding about what privacy is.
Keeping a secret is about restrict its accesses, avoiding the unintended, while allowing those intended, but as you could imagine, it's not easy to distinguish intentions, nor intention's owners. Secrets need to be visible for some, and invisible to others, so how to hide? what to hide?. Kerckhoffs's principle can also be stated in this way "A cryptosystem should be secure even if everything about the system, except the key, is public knowledge", and it immediately makes sense: "A house should remain secure even if everybody knows where the door is!".
Today we are already using some form of data encryption on most of our global communications, and most of these systems were designed being aware of this principle, it means that its designs are not secrets, but what is hidden are their keys, like the passwords, secret questions, among other kinds of keys.
Claude Shannon asked it before us, and he answered yes; how? by using a random different key for every single message, and being each key the same length as each message. This schema is called -random one time pad-, the method is like using a random invented language for every word, even for every letter we write, so a third person will find impossible to decipher our conversation from there, because the encrypted message will have no clues of the original message, but it's not a very practical technique. Why? Well, how we will tell the other what random language/keys we are using for every word? Could we both have a list of the successive language sequence? Perhaps, but how to send that list? What if someone else see our list of keys? Once you have random numbers written in a list, are they still random? as you could see randomness is fragile. So, can we send those varying keys along with the messages? Well, yes, but sending our messages along with its translations would not hide them for too long[1]. Shannon "one time pad", despite not being very practical, it's unbreakable, and is Kerckhoffs-approved!, because it's a public mechanism where all its successive keys are hidden.
[1] For completeness sake we have to mention that it's possible in principle to send keys through a Quantum scheme, but that's very far from our issue now
An obvious question arises, how designs which meet Kerckhoffs's Principle can lead to a stronger cryptosystems than without using it?. Let's fall in the extreme opposite naïve case of using only a hidden secret mechanism to encode a message, with a fixed secret (a not changeable password), this would be like hiding a secret with another, as having a secret passage door, but without lock (perhaps behind the bookcase), yes, the system will remain secure but only until it's found by an attacker, since then, all successive communications will be endanger, and even worse, it would take a long time to redesign the whole system, so it will be compromised for that while. These methods are called "security through obscurity" to belittle them, it refers to designs that hide mechanisms that are not easily changeable, imagine you have to give a specific shape and colour to a complex physical machine to fits certain hiding place, with a camouflage colour to blend into that background, it could ends up having a clumsy shape, perhaps not very suitable for what it was designed[2], and if "enemy" discover our hiding place, we have to re-conceal the machine elsewhere, shaping it again and painting every gear again; a bad idea.
Shannon outlined Kerckhoffs idea in a minimalist way: «The enemy knows the system», a straightforward manner to encourage designers to consider that others may already know our security mechanism, to be ready for when that happens.
On the other hand, a secure algorithm means that, without the proper key, it will forbid the access to protected data (or make it very difficult), even knowing how the system works, no right key, no right data, it also needs to be fast enough to be useful in practice; so if a key is compromised it can be changed faster than replacing the whole algorithm (Analogy: changing the locks is a lot easier than making a new door!, so a secure algorithm is like a well-crafted door).
If those techniques are used together, a hidden password plus a hidden and secure algorithm, it could lead for a while to a stronger and harder to break system than applying only one strategy at a time, of course if we were constrained to choose only one of them, in principle, the hidden key strategy alone is a lot harder to discover and faster to change than the hidden mechanism alone.
[2] Except that the machine were specifically built for hiding purpose only, with no other function, that would be a funny exception.
Until now we were comparing the time and resources it takes to redesign a whole system, versus what it takes to create a new password; and it turns out that passwords can be produced faster (and cheaper). Now let's consider a different and also important question, Is it easier to unravel a hidden algorithm than a hidden key?
Yes, although in practice it depends, in theory it's a resounding yes, we can even explain it without using analogies of secret doorways nor hidden machines, the fact of the matter is that most of any working algorithm needs an inner structure to work, and cryptosystems algorithms are not an exception, they usually need an structure, while passwords doesn't, so in general it's theoretically easier to get clues of that structure, to reverse-engineer or find patterns on an obscure machinery design, than to "reverse" a password that has no design structure at all by definition.
So far so good, but those are theoretical differences, however in practice the enemy often doesn't know the system, and some hidden mechanisms remain hidden, moreover although there is nothing behind a password to be reversed, in practice we don't pull passwords out from a hat, and generating a password related to nothing is not an easy job (and of course, the names of your pets are not a good resource). Anyway Kerckhoffs's principle is just a design criterion for cryptosystems, is a warning, not a full instruction manual, isn't it?.
Is a public algorithm better than a private one ?[3] This is often a topic of discussion (or even a non debatable topic), since any volunteer observer can review the public mechanism and report a bug, as well as could be the first of taking advantage of it without reporting anything, etc... But such discussions end involving people and trust (not even a perfect system could abolish these issues); so it might or it should lead us to ask, how much does the algorithm matter? what's the relative importance of an algorithm design over others factors? Ok, it's probable that a reviewed public algorithm can be more secure than a private one, but having so many other affecting things around, the question could be very misleading!. "Well, someone have to take care about the algorithm", but if the algorithm ends in a global usage recommendation, that's no longer about the algorithm.
[3]In this context the use of the word public only means that the mechanism can be known by everybody, and private here means that inner mechanism are intended to be hidden, it has nothing to do with public goods from a state nor private goods from individuals, please don't confuse them.
The Enigma Machine was a cryptosystem used during World War II, whose encryption it's said it was broken because of some human errors together with a poor security design based on hiding the machinery (it was NOT Kerckhoffs-approved!). This example from history is often shown as a kind of triumph of the theory, sometimes it's used to show how security through obscurity is poor, and how it has failed in practice.
But there are more details that worth to mention; for example, what resources were used to break it? There were a lot of people at the time involved in trying to break Enigma Machine from many powerful countries (including Alan Turing ). So, was it easy to break it?. How hard it could be to break many many different Enigma like Machines? (We have already ran out of Alan Turing's, and alternates will not be enough for every machine), I think that a large number of hidden machinery would be still a hard subject, because obscurities are not all created equal.
We should also emphasize that Enigma is not a good pedagogical example, it's misleading from scratch, because the system was used to hide war movements, so it's not an example that let us focus on cryptography, it's about war, so what is the point of coldly pointing out the weaknesses of this system ? In which sense we are saying that a more secure system would have been better? Are we suggesting to use better systems for a next war? It sounds like an advertising from an unscrupulous seller of war cryptosystems. There is no such thing as the best system isolated from all else, on the contrary, any criterion about what is best is related with people and even with everything else. Secrecy is not only about war, it's about privacy, and it's about having a space to think for ourselves, to talk with our partners, with our loved ones, with all our recipients, and with no one else.
The world has learned Kerckhoffs's principle, among other theories. Today we are all using the same tested algorithms to protect everyone's privacy (?), all for one, and one for all. Despite of that, there is a huge and growing lack of privacy, and every human word, every move is being recorded in computers. If a system knows in advance what our movements are, then under certain circumstances it could anticipate our next moves, we can be controlled by that system, be the government, be the market, be Skynet, or whoever. Is that what we want? If not, are we doing something wrong? what can we do better? The algorithm? Maybe not!, by getting the best ever public algorithm (and even because of it) the scope of its use could become dangerously global, as well as its flaws, sometimes the best is the enemy of the good.
The global: we have evolved a technology that let us communicate worldwide using same symbols, protocols, using converters, automatic translators, and compatible systems, our data is now spread worldwide like never before in history, our scope became worldwide, while most of us have a localized life, and all of us have a limited capacity to cope the whole world, certainly not enough to live spread globally as data.
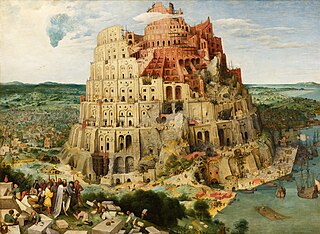
There is a singular and well known story over this issue that could be traced back to the Bible, it's called The Tower of Babel, and goes something like this: there were people trying to build a big tower, so high, that it reaches heavens, what for? to avoid being scattered around, to give themselves a name, but then The Lord confuse their languages so they will not understand each other, that's it. Something similar is happening now, we could "reach heaven" (at least some internet clouds) by sharing, and through world cooperation, but that's not easy, our selfishness, our myopia, evilness, desire of control, request of control, and so on, in resume: all of our human limitations, leads us to the need of different languages, localized, limited, like echoing our own limitations.
The local hit again: what if many universities, countries, districts, companies, groups of people uses each one a particular non-standard communication algorithm, then they can not be understood globally, but strangely as it could seems, that's sometimes what we want. Kerckhoffs's principle doesn't imply we should use all the same method. A single secure algorithm for all ? Is this idea a gimmick invented by those who want to spy easier? What about one hundred million of unknown private methods? But that way we would lose Babel, but Babel tower is dangerous, and so on...
That it's all just a little bit of history repeating
We face today a worldwide vulnerability on privacy (or voluntary surrender of privacy), inside and outside computers, and as with many other humanitarian problems of higher priority, the answer can't just be "maths is ok", because perhaps we knew that already, or nobody ask about it, we are facing problems of many levels, requiring everyone's voices and presence, it's self evident that is not enough to talk about algorithms. Encryption systems are issues of computational science mainly because secrecy and privacy are issues of human life.
A mathematical model could be perfectly correct, but applying it unquestioningly is definitely wrong, it's the old issue about the tools and its different uses, today's problems of privacy are also ethical problems, and there is an opportunity for scholars to speak about this, to join discussing about differences between general and particular, between theory and practice, to help practitioners by challenging them to think, as well to be involved in ethics, it's fine to know a theory, provided that the personal views are never silenced; but surprisingly enough the opposite advice is often given, encouraging to stick the theory, to follow the proven rules, it's like saying "don't think for yourself, someone already did it for you", but nobody can think for someone else!, it's a lie, and a very rotten idea for a general approach, "don't reinvent the wheel" is sometimes confused with "don't think for yourself", although it may be an efficient tactic for certain works, it's a very dangerous and profoundly sick ideology.
Computer software interacts with communities on a daily basis, so there is no excuse for being "detached from algorithms consequences", we should accept some kind of responsibility regarding this ways of acting. Scientist needs to think outside science. Making pure science seems like heating pure water, both may boil over.
We are humans, it's a pretty relevant fact to put aside, or it should be, dehumanization of exact sciences is sometimes getting as far as "the abstraction from being a human", and we should face that it can have very harmful consequences that are not only humanitarian ones, but also technical.
Using distributed systems, does not guarantees privacy, the central topic here is not what system is better for avoiding some limitations or weaknesses of human behaviour, but just the opposite, i.e. to avoid ignoring it, to be aware of our limits, and ourselves. What could it mean wanting to implement a single global and infallible security system but a dangerous act of alleged omnipotence that we don't have? Either the attempt of making a global system to spying, or the attempt of making a global system against spying, are two faces of the same mistake.
TheClass must have a private constructor, accepting a Builder object as argument
Builder, an inner public static class named Builder(or as you like), with same properties as TheClass.
Builder properties can have default values.
Builder must have a public constructor accepting as arguments all the required properties of TheClass.
Set methods are in Builder class for filling the optional properties of TheClass.
Those methods returns "this" i.e. a Builder object so allowing calls to be chained, like setThis(x).setThat(y).setThose(z)
Finally to create TheClass object, the cherry on top is a build() method, using new internally, and returning it. The body of build() is:
TheClass build(){ return new TheClass(this);}
Get a static Builder(with required arguments), set optional properties(chained), and build()!

Pero estos últimos años las computadoras aparecieron en primer plano apresuradamente (diría violentamente), ahora ya son inevitables, inexcusables, ubicuas. Se escucha decir entonces, casi como una consecuencia causa-efecto: "Quizás se debería enseñar a programar en las escuelas". Siento un poco de nostalgia y hasta cierta ternura al escuchar ahora hablar de algo así, que me hubiera gustado oír hace más de 20 años, cuando iba a la escuela y quería programar, me preguntaba ¿Cómo se hará un video juego, un robot?. A la vez, y por la misma razón, no puedo evitar pensar que es un poco tarde, es una llegada tardía, utilitaria y comercial, casi burda, al menos predecible, mecánica, y es muy probable que cuando se implemente en las escuelas haya ya algunos niños que quieran aprender otros temas (que quizás sean los "actuales" dentro de muchos años...).
La excusa clásica es cierta "mejor tarde que nunca", claro, lo acepto, pero también hay que revisar lo que hacemos, ¿siempre tarde? escuchar una y otra vez a la moda, al mercado y a los empresarios en urgencias por tener YA trabajadores para producir, ir entonces ahí corriendo a cambiar los planes de estudio, y promoverlos con eslogans como "la carrera del futuro", y otros menos dignos...bien, eso quizás puede ser "útil" para zafar y seguir alguna que otra zanahoria, lo entiendo y es comprensible, pero no es ninguna novedad, es lo obvio que viene sucediendo hace años, y valdría la pena entonces hacer una reflexión nueva.
¿Cuál sería una novedad? Una novedad sería escuchar, y preguntar, permitir a cada uno decir qué quiere aprender.. Alguien dirá "no se puede hacer una clase diferente para cada persona", claro, pero quizás eso no sea necesario!, el punto es que no podemos anticipar las respuestas!, hay que preguntar, arriesgarse a escuchar qué quiere cada uno; ¿Puede un plan incluir preguntas? ¿Qué hace después el docente con las respuestas? lo que sea que haga en ese momento y lugar va a ser mejor que cualquier plan fijo, confiar, porque "decidir de antemano" es, además de imposible, un miedo sin fundamento, si hoy la programación es declarada central e importante, implica que alguna vez no lo fue, como es probable que mañana ya no lo sea. La actitud de proponer a todos (y a veces obligar) a estudiar lo que hoy es "lo importante" suele ser la misma actitud que lo despreció cuando era innovación, excluir lo que hoy "no es importante" es quizás ir en contra de lo que puede ser importante mañana. Hacer preguntas no es propiciar cosas que actualmente no son útiles, sino simplemente admitirlas, darles un espacio, aunque la función de esto fuera la de fomentar la convivencia, o la de ayudar a pensar, sería ya suficiente provecho.
Hay propuestas que consisten en procurar que Lionel Messi apruebe historia, geografía y contabilidad, o que Einstein no falte a ninguna práctica de fútbol, y algunos le llaman a eso igualdad.
Esta palabra se usa para indicar que algo "no responde", en Argentina es usual decir "se tildó", "se tilda", "se tildaba", "está tildado", entre otros sinónimos como se cuelga, se congela, se friza, se bloquea, se paraliza, se clava, se traba, etc.. Esto es aplicable a cualquier dispositivo tecnológico cuando no responde (usualmente va combinada con insultos).
¿Qué tiene que ver tilde con computadoras?¿Qué origen puede tener esta conexión? Lo dejo ciertamente como hipótesis, pero es posible que provenga de los flippers, que usaban la palabra Tilt en su pantalla (Tilt en inglés se traduce como Inclinar), esto aparecía para indicar que el jugador había "inclinado" la máquina para hacer trampa y normalmente, además de esta indicación, la máquina daba por terminado el turno o el juego entero. El flipper dejaba de responder intencionalmente, no como una falla, sino que era parte de su funcionamiento para prevenir las trampas, es decir una de sus funciones posibles era dejar de funcionar, el origen de la palabra estaría entonces en esa asociación "Tilt equivale a dejar de responder".
Este es un posible ejemplo de los extraños caminos que toma el lenguaje para evolucionar, y de cómo muchas teorías generales sobre el "origen de las palabras" sean más bien estudios históricos antes que racionales ¿Cómo se puede relacionar la palabra inclinar, los acentos ortográficos y que algo deje de responder? Obviamente mediante un flipper.
La palabra tilde se usa además para nombrar al acento ortográfico: es decir, la pequeña línea que va sobre una vocal (por ejemplo en la 'o' de canción), también se le llama tilde a otros garabatos que van sobre las letras, como el de la eñe. El verbo tildar, en este contexto es la acción de dibujar el acento.
1. adj. Que hace fe, fidedigno.
Esta frase está ahora en tu mente. Antes estuvo en la memoria de una computadora, pero ¿De dónde provino? La información que percibimos nos lleva a diferentes pensamientos, conclusiones y acciones, la lectura de una noticia, un email, modifican nuestro accionar, siempre y cuando confiemos en la realidad de esa información ¿Es un mensaje creíble? ¿Es spam? ¿El autor del mensaje es quien dice ser? ¿El medio de comunicación es quien dice ser? ¿Cómo saber si "esto" es Internet y no son datos preparados para que parezca Internet? ¿Podríamos diferenciar algo simulado de algo real?
Supongamos que hubiera métodos para distinguir esa simulación ¿Cuánto tiempo estaríamos dispuestos a dedicarle al chequeo? ¿Cada vez que entramos a Internet verificamos que sea realmente Internet? No, al menos no conscientemente, y en principio existe la posibilidad de ser engañados, mediante pequeñas intervenciones a las conexiones la comunicación podría ser manipulada, justamente aprovechando la confianza que está puesta en los datos, es como si de repente viéramos mucha gente corriendo hacia algún lugar, seguramente nos preguntaríamos qué les pasa, pero si quienes corren fueran personas de nuestra confianza nos veríamos tentados a seguirlos, aún sin esperar averiguar adonde van, y aquí yace una interesante y peligrosa posibilidad de ser manipulados, es la reutilización de nuestra confianza que fue puesta en algo que creemos conocer pero que puede ser redireccionada hacia otra cosa, sin que notemos diferencia.
Internet está distribuida en diferentes computadoras, pero para el caso no importa, ya que a su efecto lo percibimos desde pocos lugares, de hecho podríamos encontrar Internet siempre en el mismo lugar (sea un mismo monitor, teléfono, etc..) encontramos a Internet mirando ese mismo pedazo de material que va cambiando de brillos y colores. Es mucho más fácil simular un "sitio web" que un "lugar físico", de más está decir que no hay que confundir ni asemejar un lugar físico a un sitio de Internet porque esto no es un lugar, los lugares físicos tienen mucha más inercia, están compuestos de miles de millones de átomos, donde cada uno tiene además su complejidad, un lugar físico se puede reformar para parecerse a otro lugar, sea una casa o una zona de la ciudad (tal cual se hace en un estudio de cine, al mejor estilo Truman Show) pero es extremadamente difícil hacerlo, no es en absoluto práctico. Sin embargo es relativamente fácil modificar un sitio de Internet al que acostumbramos a entrar, por ejemplo el email, las noticias, o incluso una búsqueda en Google, más aún si el cambio es sólo visible desde unos pocos dispositivos y conexiones que son los que habitualmente utilizamos, que pueden ser sencillamente identificadas como nuestro grupo de acceso, y de hecho lo son, ya sabemos cómo se adaptan las publicidades y páginas al país, a la localidad, al idioma e incluso a nuestros gustos personales, esta identificación hace que los resultados que vemos no sean los mismos que ve el resto del mundo, y no podemos ir a preguntarle al resto si ve lo mismo, lo que percibimos como "Internet" es relativo al punto de conexión, al navegador, y al usuario, y así está pensado, para que lo que vemos sea "relevante" a nuestro contexto, lo cual en teoría tiene mucho sentido, pero todo es doble filo y lo relevante para nuestro contexto podría convertirse en una simulación preparada para nuestro contexto, lo cual es menos agradable y mucho más simple de hacer que remodelar una casa o una ciudad, se podría preparar una "Internet simulada" para una persona o un grupo sin que ellos ni los demás siquiera se enteren, sobretodo si hacen un uso reducido de Internet, es decir si entran siempre a los mismos sitios y no chequean la información, que a veces por la urgencia no hay tiempo de comprobar, eso facilitaría el engaño porque habría menos cosas que cambiar (de hecho el reemplazo de páginas puntuales ya ocurre en la práctica como forma de ciberdelincuencia denominada phishing)
De similar manera se podría "simular" Internet y generar así una percepción distorsionada de la "realidad"(digital), que a veces se toma como un eco de sucesos reales , lo cual podría no ser así. Esto se volvería especialmente grave si el grupo de personas engañadas, sujetos al simulacro, estuvieran en un lugar de poder, por ejemplo si los engañados son políticos, policías, etc.. ¿Pueden ellos tomar decisiones confiando en lo que les dicen sus computadoras?
Este problema no tiene solución general, ni siquiera afuera de Internet, es decir, no hay manera cierta de descifrar si algo es real o no, sabemos que el sol existe porque la mayoría de la humanidad y sus instrumentos están de acuerdo, y si alguno lo negara, antes de dudar del sol, dudaríamos del instrumento o de la persona, (por no estar de acuerdo podría ser etiquetado incluso de no estar cuerdo), así funciona la estadística y en un punto la ciencia, son formas del conocimiento, es mediante una especie de democracia que sabemos qué cosa es real y cual no. Por tanto en el caso de Internet nos quedaría preguntarles a otros, ¿Están viendo lo mismo que yo? y cuantas más personas estén de acuerdo, pensaremos que es más "real", un acuerdo estadístico, por convención, en el mismo sentido que lo tenemos sobre el sol. Esto sin embargo no asegura nada; y por dar un ejemplo, Douglas Hofstadter investigador y escritor, al ver en Internet errores sobre su propia biografía intentó editarlos, pero como alguna mayoría pensó que sus ediciones estaban mal, las "corrigieron", esto lo comenta en una entrevista :
Hofstadter: -"El artículo de Wikipedia sobre mí contiene inexactitudes y eso me deprime"
Periodista: -"Entonces podes arreglarlo"
Hofstadter: -"Al día siguiente alguien lo va a volver a poner como estaba"
(Fuente: entrevista de Deborah Solomon para NYT en 2007)
Aún teniendo en cuenta este tipo de problemas, la decisión por mayorías es algo que se hace,(y en este caso a raíz de ese reportaje se podría llegar a una mejor solución, pero no todos los ciudadanos podrían tener una entrevista para reivindicarse...), como fuere éste es el método que tenemos, observar la cantidad y la diversidad de los datos, poder consultar a otras personas y otras fuentes, es central, si en cambio le falta diversidad a los datos podríamos sospechar que tienen una sola fuente, la variabilidad aquí en lugar de ser una imprecisión es una pista que nos permite sospechar de una fuente independiente y no comandada por alguna intención simple, única y centralizada (en nuestro análisis sería la intención detrás del simulacro), pero no podemos estar seguros, la cantidad y la diversidad a lo sumo pueden tomarse como pistas de realidad, así como la escasez y la no variabilidad de un dato dan sospecha de un engaño, podría no serlo.
La desconfianza, es siempre provisoria, parece apenas un camino que suele llevarnos a confiar en otra cosa, como dijimos, usualmente confiamos en la realidad de algo cuando podemos compartir la visión con otros, cuando otros también lo ven, cuando lo que percibimos está matizado desde muchos lugares, con diferentes puntos de vista y en diferentes formas, algo luce real cuando es "demasiado complejo" para una simulación, demasiado complejo para ser falso, insisto sin embargo en que no podemos estar seguros ¿Cuándo es algo demasiado complejo para ser falso? algo bien podría ser "lo suficientemente complejo" para que parezca real, y sería suficiente para que no podamos detectar diferencias, alcanzaría para engañarnos, y si detrás de algo hubiera una intención compleja, podría pasar como realidad ¿Internet dificulta entonces convenir sobre la realidad? No, porque tampoco existía ese acuerdo antes de Internet, no hay que sorprenderse porque no hay aquí novedad, basta leer a los físicos, a los poetas y a los filósofos que hace tiempo nos cuentan que nunca estuvimos seguros de la realidad, que no hemos llegado a acuerdos definitivos, y que posiblemente nunca los vamos a tener, intentando comprobarla, se nos escapa, y ante cada respuesta nueva nos llena de preguntas que nos piden lo mismo: confiar.
"El simulacro no es lo que oculta la verdad, es la verdad la que oculta que no hay verdad, el simulacro es verdadero" -Jean Baudrillard
open direccion_ftp.com
userFtp
passFtp
get file.txt
quit
ftp -s:cmd.ftp
SalidaC:\path>download.bat
C:\path>ftp -s:cmd.ftp
ftp> open direccion_ftp.com
Conectado a direccion_ftp.com.
220 "Bienvenido al servidor de FTP"
Usuario (direccion_ftp.com:(none)):
331 Please specify the password.

230 Login successful.
ftp> get file.txt
200 PORT command successful. Consider using PASV.
150 Opening BINARY mode data connection for file.txt (1024 bytes).
226 Transfer complete.
ftp: 1024 bytes recibidos en 0,02 segundos 77,31 a KB/s.
ftp> quit
221 Goodbye.
Cuidado: el archvo cmd.ftp va a contener usuario y password del ftp, y lo podría ver cualquiera, cosa que no suele ser buena idea.
 Soft Libre...de Intención?
En las obras bellas no suelen usarse las armas, y si la GPL no permite cerrar el código con el fin de auto-sostenerse y propagarse ¿Porque no resignar entonces otra libertad con algún fin más humano? ¿Valorar la vida?.
Como el Software Libre no le permite al programador decidir a quién entregar su código fuente una vez liberado, quien utilice la licencia GPL está obligado a perder el control sobre dónde, quién y para qué se utilizará su trabajo, su código fuente, para así dar libertad al software en sí mismo, y supongamos también quizás al usuario.. Se resigna cualquier intención original a cambio de que el código siga siendo abierto.
Podríamos preguntarnos, si el software puede copiarse de todas formas, y la licencia no es más que para declarar intenciones; (porque sabemos que una vez liberado un software, cerrado o abierto, nada se puede hacer con el uso que se le da, incluso un software cerrado podría reutilizarse) aún así, quizás la pregunta es entonces cuáles son esas intenciones nuestras, cuál es nuestra postura en esa declaración, ¿Es para nosotros más importante declarar nuestro apoyo irrestricto a la propagación de un código fuente y auto-sustentar una licencia, que contar nuestras intenciones sobre sustentar la vida y la paz , evitando así "ensuciar" la licencia con cuestiones humanas ?
Así puede ser para unas personas, pero no para otras. Por tanto, ya que hablamos de libertad, llevémosla al terreno de un programador que debe elegir su licencia, y por tanto se puede admitir la diversidad de opciones (cosa que no asegura la libertad pero al menos permite una parte). Lo que podemos proponer es que la GPL sea siempre opcional, y quien no quiera publicar su código tenga siempre la libertad de no publicarlo.
Que cada uno pueda decidir es poner por encima una libertad y un derecho humano a un derecho maquinal, una libertad para bits ( no sé por cuanto tiempo sean más importantes los humanos que las máquinas, pero podemos hacer algo mientras ).
Incluso puede que alguien quiera publicar su código, pero no para cualquier fin, lo cual es un poco paradójico porque al publicar ya dijimos no hay chance de controlar la finalidad del source, sin embargo, aún así se puede declarar una intención, y por ejemplo quien esté interesado en apuntar sus intenciones a la paz, puede publicar con una licencia "Peaceful" GPL en lugar de la GPL.
El software libre es muy importante, tanto como el software privativo. Creo entonces que no debería prohibirse ninguno.
No hay ninguna necesidad de discutir acerca de si hay fines bélicos correctos o incorrectos. Sencillamente hay gente que preferiría usar una PGPL (GPL Pacifica) y puede expresar su intención.
¿Queda claro que: "Por más que pongamos cláusulas, lo pueden igual usar ilegalmente...."? Clarísimo, pero las licencias libres también pueden ser usadas ilegalmente cerrando el código, sin embargo, sus cláusulas siguen ahí! (que obligan a entregar el código fuente)... Esto es porque las cláusulas así como las leyes de un país, no eliminan el delito, sino que representan una postura, una filosofía, un ideal al cual apuntar a que sea parte de la cultura. ¿Cuál es el ideal del software libre, y quién posee esa libertad además del mismo soft? Probablemente hay una comunidad que NO es representada por una GPL o cualquier licencia de soft libre a la que "le da lo mismo" si el código es utilizado para un juego que para matar personas. Y estos comentarios que estoy haciendo son un parche que se sabe poco útil de entrada porque no soluciona el problema, pero su objetivo es otro, es dejar bien clara una postura para invitar a la paz, y no a la indiferencia.
Agregado Pacifista :Este agregado es para hacer notar que la reutilización del código puede tener la finalidad más insospechada. Y si ya somos lo suficientemente inconscientes como para desarrollar tecnología, podríamos decir al mundo que se puede dar un mal uso, y si se da un mal uso : "No es nuestra intención", que si le dan un mal uso lo tendrán que hacer ilegal, para no ser cómplices porque lo rechazamos desde el origen mismo.
"Esta prohibido utilizar el software que cubre esta licencia (source y binario) directa o indirectamente
o como parte de otro software con el objetivo de causar daño a seres humanos, la fabricación de armas o para ser usado en cualquier tipo de aplicaciones bélicas. Al autor de este software No le da lo mismo cualquier aplicación de su trabajo."
"Lo preocupante no es la perversidad de los malvados, sino la indiferencia de los buenos" Martin Luther King
En el caso de las computadoras y los lenguajes de programación también hay tareas que, si bien las podemos imaginar, No son realizables mediante ningún número de pasos (por ejemplo no se puede resolver el Halting Problem mediante un algoritmo), otras cosas que son independientes del lenguaje son ciertas operaciones básicas, mínimas; todos los lenguajes coinciden en esos límites teóricos, pero no coinciden en los prácticos; ahí está la dependencia con el lenguaje, en la práctica aparecen diferencias, mientras que en algunos lenguajes es muy simple lograr ciertas funcionalidades, esas mismas se hacen muy complejas en otros, dando un ejemplo básico, algunos microprocesadores son capaces de hacer multiplicaciones con una sola instrucción, y otros no, para multiplicar deben usar una secuencia de sumas, en este caso la misma operación se complica, y esta diferencia de complejidad puede crecer arbitrariamente (me refiero a que puede haber problemas que siendo muy simples en un lenguaje pueden llegar a ser impracticables en otro), por lo tanto cada lenguaje tendrá su performance, su belleza, su efectividad en cierto ámbito (tal cual lo tienen las diferentes formas de pedirle la hora a alguien..).
Lo mínimo que podemos hacer, y lo que seguro no podemos, es común a todos los lenguajes, eso no depende de cual, pero lo que "quizás" podemos hacer, eso sí depende del lenguaje usado, incluso depende de poder encontrar ese lenguaje a usar... ese es el futuro abierto.
Muchas veces se discute si un lenguaje es mejor que otro, se olvida decir mejor en qué o para qué, por ejemplo no se aclara si en la discusión si se comparan también las librerías disponibles, que ya traen aparejada una semántica, en realidad si se tuviera todo eso en cuenta la discusión se tornaría ridícula, supongamos que alguien tome el buscador google y diga "este buscador ejecuta su código finalmente en computadoras, es decir en instrucciones mínimas de microprocesador, por lo tanto, es ese el lenguaje que 'realmente' hace las búsquedas", otra persona al mismo nivel de miopía produce un texto como "hice un script en el lenguaje X que permite usar múltiples buscadores automáticamente, y poner resultados en una lista, por lo tanto X es el mejor lenguaje", en el primer caso vemos que se está omitiendo que el código ejecutable en instrucciones nunca pudo haber sido escrito así directamente por seres humanos, la complejidad requiere para nosotros de las capas de abstracción, no podemos manejarla en crudo, por lo tanto no puede hablarse de que las instrucciones compiladas y después desensambladas sean un lenguaje en sí, (salvo que asignemos el mérito del Quijote ya no al escritor Cervantes, sino a la tinta en sí, porque "de eso está hecho el Quijote"..), por otro lado, en el segundo caso del lenguaje X, se pierde de vista que está haciendo uso del trabajo de muchas personas, y mucho tiempo de evolución, y en definitiva otros lenguajes, y no debería asignarse todo el mérito, porque no lo tiene, muchas veces usan directamente librerías escritas en otros lenguajes, o ideas que no podrían estar ahí, sin los demás lenguajes..
Sería lindo logremos esa humildad, admiración, que muchos pudiéramos pensar sobre este tema como Newton pensó alguna vez sobre sus logros : "Si he podido ver más allá que otros es porque me he apoyado en hombros de gigantes", pero ese tipo de reflexión parece poco popular, casi prohibida. Como suele ocurrir, por razones que no voy a exponer acá, cada vez que aparece una visión o un lenguaje nuevo, hay una tendencia a buscarle ventajas y desventajas, para tratar de eliminar o imponer.
Ahora, pensando en la semántica que hoy existe, y me refiero a los logros computacionales que conocemos, se puede ver que siempre se le puede asignar a esas funciones un nombre, y que estas sean a la vez palabras de otro lenguaje de jerarquía superior, etc, parir una nueva gramática es producto puro de la evolución (como los paradigmas funcional, estructurado, de objetos..), y no es obvio que alguna sea más poderosa "en sí", porque sólo podemos evaluarla mediante la semántica, por otro lado, comparar sólo la sintaxis no aporta mucho. Imaginemos (y no hay que imaginar mucho) que todos los desarrollos de software del mundo, pudieran ser accedidos mediante un hipotético lenguaje Z, y a lo sumo luego de una posible ceremonia de compilación se puedan ejecutar sendos servicios del más alto nivel alcanzado hasta el momento, generando así nuevos desarrollos de aún más alto nivel, Z1, Z2, Z3.., Z++, Z#,...
Obviamente la semántica alcanzada hoy es dependiente de una gramática subyacente, no arbitraria pero sí contingente, es decir hay multiplicidad de opciones para alcanzarla, el secreto es cierto "umbral" de efectividad, que la hace invisible, cuando una funcionalidad logra cierta efectividad aceptable ya no es tan dependiente de la forma, es decir lo que el software hace (semántica) si lo hace eficientemente se libera en mucho de las contingencias gramaticales del lenguaje.
Ya hay servicios a este nivel como para armar lenguajes, procesos y funcionalidades, por un lado todos los frameworks, y lenguajes, por otro los servicios webs, e incluso páginas como ifttt.
Ejemplo en lenguaje Z.
Recipe getRecipe( String searchString )
{
    Google google=Google.getInstance();
    Internet inet=Internet.getInstance();

    return inet.google.find(searchString);
}
int main()
{
Recipe recipe = getRecipe(" How to time travel ");
recipe.follow();
return 0;
}
git initgit add archivo.txtgit commitgit add . (agrega al Index los archivos en carpeta, modificados y nuevos, sin actualizar los borrados)
git add -u . (agrega al Index modificados y actualiza borrados, sin agregar los nuevos)
git add --all . ( agrega todos los cambios al Index, es decir ambas anteriores)
git statusgit loggit config --global user.name "nombre"
git config --global user.email "nombre@mail.com"
git config --global --edit[user]
name=nombre
email=nombre@mail.comgit branch ramaTrabajo
git checkout ramaTrabajogit merge fixcat .git/HEADtype .git\HEADgit remote add origin direccion_web_del_repogit remote add origin https://github.com/nombreUsuario/proyecto.git

// Comentario
 int main(void)
 {
     printf("hola mundo" );
     return 0;
 }
# Comentario
print ("hola mundo")
#Definiendo main como función
def main():
    print ('hola mundo')      #1
if __name__ == '__main__':    #2
    main()
#Aprovecho a mencionar una singular forma de repetir strings
print("hola mundo " * 5)
print "hola mundo"print ("hola mundo")#coding: latin-1#Imprime el elemento 3
#Va a imprimir la D (ya que empieza en indice=0 tal como los array de C)
lista = ['A', 'B', 'C', 'D', 'E']
print( lista[3] )
#coding: latin-1
#Ahora vamos a usar 'comprehension' para extraer datos
#Se obtienen, modifican e imprimen todos los elementos de la lista
#multiplicando cada valor por 2
#Observar que la palabra elemento sólo se usa para referenciar el item
#puede usarse cualquier nombre de variable
#(abajo está la misma operación mediante for (sin comprehension) )
listaNumeros = [100, 200, 300, 400, 500]
listaCompre= [2*elemento for elemento in listaNumeros]
print(listaCompre)

listaClasic = []
for valor in listaNumeros:
    listaClasic.append(2*valor)

print(listaClasic)
#coding: latin-1
#Hacemos un poco más complejo el comprehension agregando unos if's
#Para modificar y seleccionar algunos items de la lista
#(Notar que la condición la chequea antes de hacer la operación)
listaNumeros = [1, 2, 3, 4, 5]
listaSelecta =[10*valor for valor in listaNumeros if valor>=3]
print(listaSelecta)

listaDos=['hola', 'cómo', 'va']
listaFiltrada = [valor for valor in listaDos if valor!='hola']
print(listaFiltrada)

- CONFIG1 0x300000 CONFIG1L
0x300001 CONFIG1H
- CONFIG2 0x300002 CONFIG2L
0x300003 CONFIG2H
- CONFIG3 0x300004 CONFIG3L
0x300005 CONFIG3H
- CONFIG4 0x300006 CONFIG4L
0x300007 CONFIG4H
   #pragma config CPUDIV = NOCLKDIV
   #pragma config USBDIV = OFF
   #pragma config FOSC = HS
   #pragma config PLLEN = ON
... #FUSES NOWDT
#FUSES WDT128
#FUSES HS
#FUSES NODEBUG
...__CONFIG(1, DEBUG_OFF & XINST_OFF & STVREN_ON & PLLDIV_1 );
__CONFIG(2, IESO_OFF & FCMEN_OFF & LPT1OSC_ON );
__CONFIG(3, DSWDTPS_8192 & DSWDTEN_OFF & DSBOREN_OFF);
__CONFIG(4, WPDIS_OFF);